KI-Anwendungen können fehlerhafte Produkte erkennen, Prozessabweichungen vorhersagen oder qualitätsrelevante Informationen bereitstellen. Ob sie ihre jeweilige Aufgabe zuverlässig erfüllen, hängt wesentlich von ihrer Datenbasis ab. Entscheidend ist, ob die Daten für den vorgesehenen Einsatz geeignet sind.
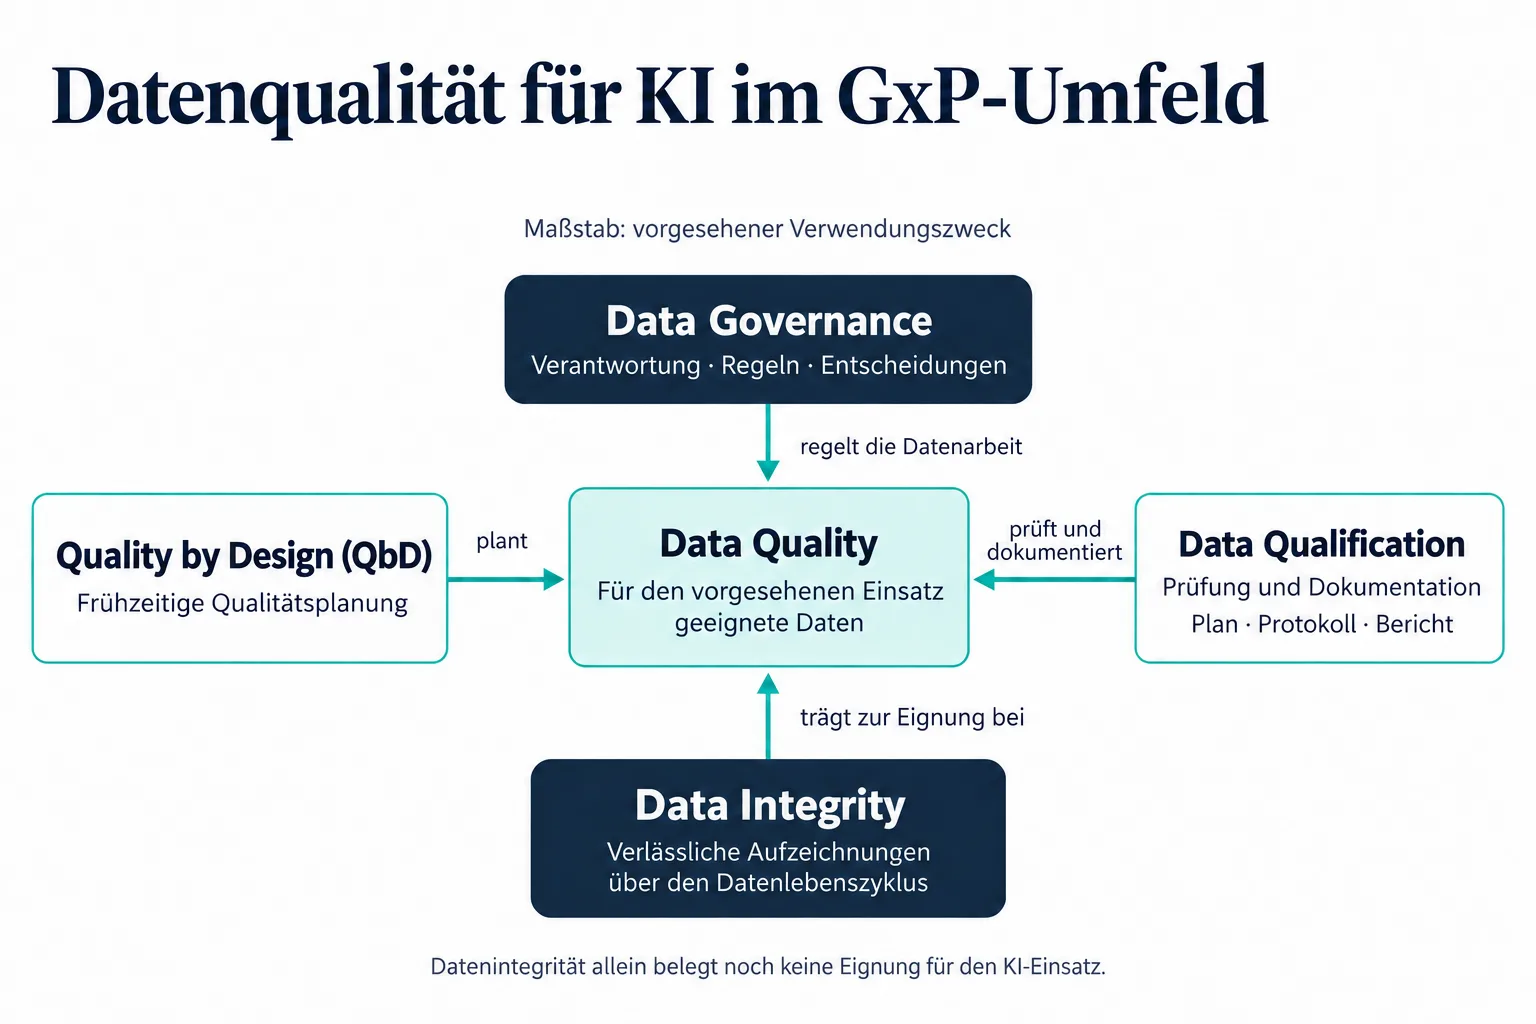
Datenqualität, Data Governance und Datenqualifizierung greifen dabei ineinander: Datenqualität beschreibt, wie gut Daten die Anforderungen des vorgesehenen Einsatzes erfüllen. Data Governance regelt Verantwortlichkeiten und den Umgang mit Daten über deren Lebenszyklus. Datenqualifizierung prüft und dokumentiert die Eignung einer konkreten Datenbasis für den festgelegten Zweck. Quality by Design (QbD) unterstützt die frühzeitige Planung der benötigten Datenqualität.
Die regulatorischen Beispiele dieses Artikels stammen überwiegend aus dem Arzneimittel- und GMP-Umfeld. Für andere GxP-Anwendungen ist die jeweilige Anwendbarkeit gesondert zu bestimmen.
Datenqualität ist zweckgebunden
Ein Datenbestand kann für seine ursprüngliche Verwendung ausreichend sein und für einen neuen KI-Einsatz wesentliche Lücken aufweisen.
Temperaturdaten eines Thermoschranks, etwa eines Inkubators, verdeutlichen das: Für einen monatlichen Trendbericht können Stundenmittelwerte genügen. Soll eine KI hingegen Veränderungen im Temperaturregelverhalten erkennen – etwa schleichende Temperaturdrifts, kurze Temperaturspitzen oder zunehmende Schwankungen –, muss die Datenbasis diese Veränderungen ausreichend abbilden. Stundenmittelwerte können dabei trotz korrekter Berechnung und vollständiger Archivierung wichtige zeitliche Muster verdecken. Entscheidend sind deshalb eine zur Aufgabe passende zeitliche Auflösung der Originalmesswerte und eine ausreichende Beobachtungsdauer.
Auch wenn das Temperaturmonitoringsystem eines Inkubators validiert ist, belegt dies nicht automatisch die Eignung seiner exportierten Daten für die KI-Anwendung. Zu bewerten ist, ob der Export die benötigten Werte und Metadaten enthält und ob die Daten die vorgesehenen Einsatzbedingungen ausreichend abbilden.
Ausgangspunkt ist deshalb der vorgesehene Verwendungszweck, häufig als Intended Use bezeichnet: Welche Aufgabe übernimmt die KI? Welche Entscheidung beeinflusst sie? Für welche Produkte, Prozesse und Betriebsbedingungen soll sie eingesetzt werden? Welche Folgen hätten fehlerhafte Ergebnisse?
Aus diesen Fragen ergeben sich die Datenanforderungen. Bei einer Sichtprüfung von Verpackungen sind beispielsweise Fehlerarten, Verpackungsvarianten und Aufnahmebedingungen relevant. Bei einer Prozessvorhersage können Messfrequenz und die zeitliche Zuordnung von Messwerten entscheidend sein.
Datenintegrität und Dateneignung gemeinsam betrachten
Im GxP-Umfeld gehört Datenintegrität zur Grundlage verlässlicher Aufzeichnungen. Die ALCOA++-Prinzipien beschreiben Anforderungen an Zuordenbarkeit, Lesbarkeit, Erfassung zum Zeitpunkt der jeweiligen Tätigkeit, Originalaufzeichnungen und Richtigkeit. Hinzu kommen Vollständigkeit, Konsistenz, dauerhafte Erhaltung, Verfügbarkeit und Rückverfolgbarkeit über den Datenlebenszyklus. (EMA/INS/GCP/112288/2023, Abschnitt 4.5)
Datenintegrität allein belegt noch nicht die Eignung für eine konkrete KI-Anwendung. Auch integre Aufzeichnungen können seltene Produktfehler nicht enthalten oder die Einsatzbedingungen anderer Standorte unzureichend abbilden.
Außerdem benötigen Daten ihren fachlichen Zusammenhang. Ein Messwert wie „pH 7,0“ ist ohne Angaben zu Probe, Zeitpunkt, Methode und Ergebnisstatus kaum belastbar zu bewerten. Solche beschreibenden Informationen heißen Metadaten. Fehlen beim Export die für Zuordnung und Interpretation erforderlichen Metadaten, ist die exportierte Datenbasis für diesen Zweck unvollständig und nicht eindeutig bewertbar. (PIC/S PI 041-1, Abschnitt 9.1.5.2 und Glossar „Metadata“)
Für die Bewertung einer Datenbasis sind insbesondere folgende Qualitätsmerkmale relevant:
| Qualitätsmerkmal | Zentrale Frage |
|---|---|
| Richtigkeit | Stimmen Werte, Zuordnungen und Referenzbewertungen? |
| Vollständigkeit | Sind die benötigten Daten und Metadaten vorhanden? |
| Einheitliche Bedeutung | Werden Begriffe, Einheiten und Statusangaben quellenübergreifend gleich verwendet? |
| Repräsentativität | Sind relevante Einsatzbedingungen, Varianten und Fehlerfälle abgebildet? |
| Rückverfolgbarkeit | Lassen sich Ursprung und Verarbeitung nachvollziehen? |
| Verfügbarkeit und Aktualität | Stehen die richtigen Datenversionen zum benötigten Zeitpunkt den berechtigten Personen und Systemen zur Verfügung? |
Welche Qualitätsmerkmale besonders wichtig sind und welche Akzeptanzkriterien dafür festgelegt werden, hängt von der Aufgabe und den damit verbundenen Risiken ab.
Repräsentativität braucht Prozessverständnis
Eine KI-Sichtprüfung soll konforme und fehlerhafte Verpackungen unterscheiden. Enthält ihre Datenbasis überwiegend gut ausgeleuchtete Standardverpackungen, fehlen möglicherweise schwierige Fälle: Reflexionen, kleine Defekte oder zulässige Varianten, die einem Fehler ähneln. Welche Fälle relevant sind, lässt sich nur mit Kenntnis des Prüfprozesses beurteilen. Prozess- und Prüfexperten sollten deshalb frühzeitig an der Zusammenstellung und Bewertung der Datenbasis mitwirken.
Mehr Bilder derselben Standardsituation schließen diese Lücken nicht. Die Daten müssen den vorgesehenen Einsatz begründet abdecken, etwa unterschiedliche Verpackungsformate und Prüfbedingungen. Seltene, kritische Produktfehlerarten und relevante Untergruppen sind dabei gesondert zu berücksichtigen. (Annex-22-Entwurf, Abschnitte 3.2 und 5.1)
Wie ein ungeeignetes Akzeptanzkriterium zu einer falschen Bewertung führen kann, zeigt ein vereinfachtes Beispiel: Von 1.000 Prüffällen sind 990 konform und zehn fehlerhaft. Eine KI, die sämtliche Verpackungen als konform einstuft, erreicht eine Gesamtgenauigkeit (Accuracy) von 99 Prozent. Wäre als einziges Akzeptanzkriterium eine Accuracy von mindestens 99 Prozent festgelegt, würde das Modell dieses Kriterium erfüllen, obwohl es keinen einzigen Fehler erkennt. Das Akzeptanzkriterium wäre damit für den vorgesehenen Zweck ungeeignet. Deshalb ist die Leistung für relevante Produktfehlerarten und Untergruppen gesondert zu betrachten. Der Umfang der Testdaten und ihrer relevanten Untergruppen muss eine statistisch belastbare Bestimmung der Leistungskennzahlen ermöglichen.
Ebenso wichtig ist die fachliche Referenzbewertung. Beim überwachten Lernen erhalten einzelne Bilder Zuordnungen wie „konform“ oder „Riss“. Diese Zuordnungen heißen Labels. Die zugrunde liegende Referenz wird häufig als Ground Truth bezeichnet. Sie benötigt ein belastbares Verfahren zur Festlegung und Überprüfung, einschließlich des Umgangs mit Grenzfällen und unterschiedlichen Expertenbewertungen. Für Testdaten behandelt dies auch der Annex-22-Entwurf in Abschnitt 5.3. (Entwurfsdokument)
Datenmenge, Abdeckung und Referenzqualität sind daher gemeinsam zu beurteilen. Eine allgemeingültige Mindestzahl an Bildern oder Prüffällen lässt sich unabhängig vom Anwendungsfall nicht festlegen. Der erforderliche Umfang hängt von der Aufgabe, relevanten Untergruppen und der benötigten statistischen Aussagekraft ab.
Quality by Design: Qualität frühzeitig einplanen
QbD ist in der pharmazeutischen Entwicklung etabliert. ICH Q8(R2) beschreibt einen systematischen Entwicklungsansatz, der mit vorab festgelegten Zielen beginnt und wissenschaftliches Produkt- und Prozessverständnis mit Qualitätsrisikomanagement verbindet. (ICH Q8(R2), Teil II, Abschnitt 4)
Dieser Gedanke lässt sich methodisch auf KI-Daten übertragen: Aus der späteren Aufgabe werden frühzeitig Anforderungen an Datenerzeugung, Auswahl und Verarbeitung abgeleitet. Die Übertragung des QbD-Gedankens auf KI-Daten ist ein hier vorgestellter methodischer Ansatz und keine eigenständige regulatorische Vorgabe.
Bei der Sichtprüfung werden beispielsweise relevante Produktfehlerklassen und zulässige Produktvarianten bestimmt, bevor die Datenbasis zusammengestellt wird. Aufnahmebedingungen, Metadaten und fachliche Referenzbewertungen werden von Anfang an berücksichtigt.
Auch Regeln für die Datenbereinigung gehören in diese frühe Planung. Ein ungewöhnlicher Wert kann ein Übertragungsfehler sein, aber ebenso eine reale Prozessabweichung. Wird er pauschal entfernt, kann ein für die KI wichtiger Fall verloren gehen. Bereinigung und Ausschlüsse benötigen deshalb eine fachliche Begründung. Für Testdaten behandelt der Annex-22-Entwurf die vorab festgelegte Vorverarbeitung sowie die Dokumentation und Begründung von Bereinigungen und Ausschlüssen. (Abschnitte 5.4–5.5)
QbD lenkt die Aufmerksamkeit damit auf die Entstehung der Datenqualität. Wiederkehrende Lücken sollten möglichst dort behoben werden, wo Daten erfasst und verarbeitet werden.
Data Governance regelt Verantwortung und Entscheidungen
Qualitätsregeln bleiben nur wirksam, wenn Zuständigkeiten und Entscheidungswege geklärt sind. Hier setzt Data Governance an. PIC/S versteht darunter die Gesamtheit der Vorkehrungen zur Sicherung der Datenintegrität über den Lebenszyklus. Dazu gehört auch die Zuordnung von Verantwortung für die Daten. (PIC/S PI 041-1, Abschnitte 5.1–5.2)
Für KI-Daten umfasst dies auch die dauerhafte Sicherung ihrer Eignung für den vorgesehenen Einsatz. Eine praktikable Aufgabenverteilung kann so aussehen:
- Data Owner: verantwortet fachliche Bedeutung, Verwendungszweck und Qualitätsregeln.
- Data Steward: pflegt Definitionen, überwacht Datenqualität und koordiniert die Bearbeitung von Datenproblemen.
- IT und Systemeigner: verantworten im Rahmen ihrer festgelegten Zuständigkeiten Datenflüsse, Berechtigungen, Datensicherheit und Systembetrieb.
- QA und Prozesseigner: übernehmen die im Qualitätsmanagementsystem vorgesehenen Prüf-, Bewertungs- und Freigabeaufgaben.
Die Funktionen können unterschiedlich organisiert sein. Entscheidend sind Kompetenzen und eindeutige Entscheidungsrechte.
Zur Governance gehört außerdem Data Lineage, die nachvollziehbare Herkunfts- und Verarbeitungskette. Sie verbindet die ursprüngliche Erfassung mit Auswahl, Transformationen und späterer Verwendung. Wird ein Datenfehler entdeckt, hilft diese Kette, betroffene Aufzeichnungen und Datenbestände sowie gegebenenfalls Modellversionen zu identifizieren.
Datenqualifizierung schafft einen nachvollziehbaren Eignungsnachweis
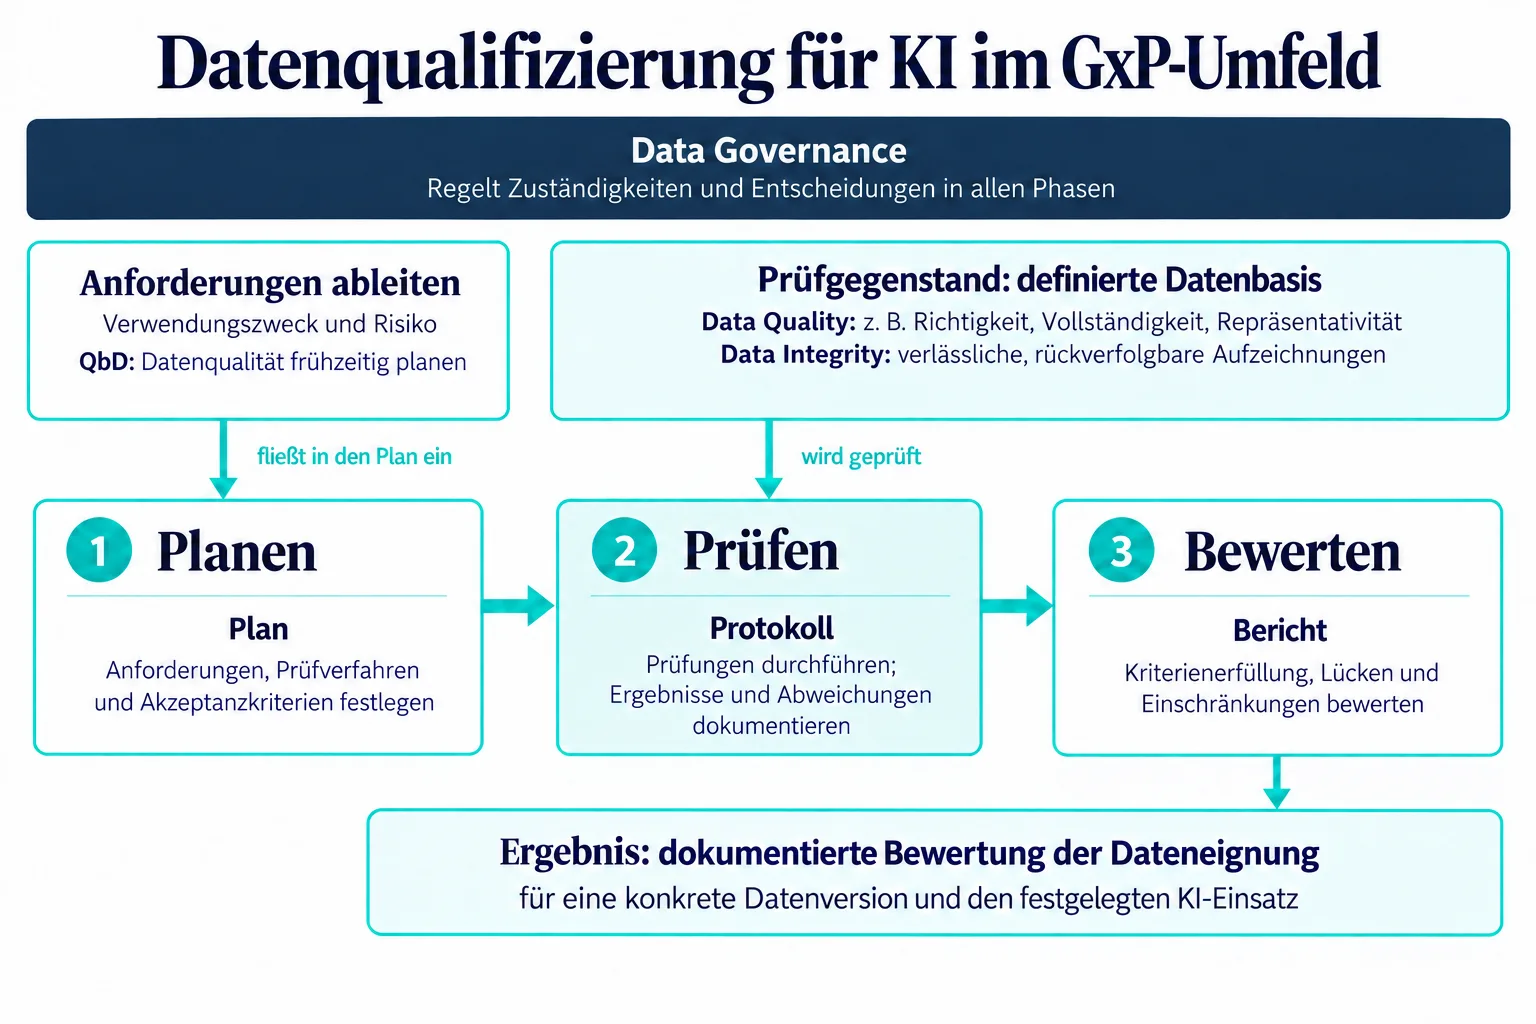
Ob eine Datenbasis für den vorgesehenen KI-Einsatz geeignet ist, lässt sich systematisch prüfen und dokumentieren. Als Datenqualifizierung wird hier ein methodisches Vorgehen bezeichnet, das Prüfplanung, Durchführung und abschließende Bewertung umfasst.
Eine zweckmäßige Dokumentationsstruktur besteht aus Datenqualifizierungsplan, Datenqualifizierungsprotokoll und Datenqualifizierungsbericht. Diese Dokumenttitel sind keine allgemeingültige regulatorische Vorgabe. Ihre Inhalte können in vorhandene Validierungs- und Qualitätsprozesse integriert werden.
Der Datenqualifizierungsplan definiert Anforderungen und Prüfungen
Der Plan legt fest, welcher Datenbestand für welche Verwendung beurteilt wird. Er beschreibt relevante Qualitätsmerkmale, Risiken, Prüfverfahren und Akzeptanzkriterien sowie Zuständigkeiten und den Umgang mit Abweichungen.
Dazu gehört bei selbst entwickelten oder angepassten Modellen auch die Unterscheidung zwischen Trainingsdaten, Tuning- beziehungsweise ML-Validierungsdaten und unabhängigen Testdaten. ML-Validierungsdaten dienen der Modellauswahl und Optimierung. Sie sind nicht mit der GxP-Validierung des Gesamtsystems gleichzusetzen. (EMA-Reflection-Paper, Abschnitt 2.5.2)
Unabhängige Testdaten sollen zeigen, wie das festgelegte Modell mit bislang nicht zur Entwicklung verwendeten Fällen umgeht. Verschiedene Ordner gewährleisten diese Unabhängigkeit noch nicht: Bilder derselben Verpackung können eng zusammenhängen. Auch wiederholte Modellanpassungen anhand desselben Testsatzes können dessen Aussagekraft beeinträchtigen. Dieser direkte oder indirekte Einfluss von Testinformationen auf die Entwicklung wird als Data Leakage bezeichnet. (Annex-22-Entwurf, Abschnitte 6.1 und 6.4)
Ein Akzeptanzkriterium für die Datenqualität kann beispielsweise die korrekte und nachvollziehbare Zuordnung jedes Testbildes zu einem Referenzprüfkörper, etwa einer Verpackung mit definiertem Defekt, und zu dessen überprüfter Referenzbewertung sein. Die Erkennungsleistung für einen Defekt ist dagegen ein Modellleistungskriterium. Ein geeigneter Datenbestand ermöglicht die Leistungsbewertung, nimmt deren Ergebnis aber nicht vorweg.
Das Datenqualifizierungsprotokoll dokumentiert die Durchführung
Das Protokoll hält fest, welche Prüfungen tatsächlich ausgeführt wurden und welche Ergebnisse vorliegen. Dazu gehören die geprüften Versionen der Datenbestände, verwendete Prüfwerkzeuge, Verweise auf Prüfnachweise und festgestellte Abweichungen.
Bei einer Sichtprüfung können beispielsweise die Zuordnung der Testbilder zu den Referenzprüfkörpern und deren Referenzbewertungen, unzulässige Überschneidungen zwischen Testdaten und den für Training oder Tuning verwendeten Daten oder die Abdeckung relevanter Produktfehlerklassen untersucht werden.
Wesentlich ist die Nachvollziehbarkeit. Eine Aussage wie „Labels geprüft“ reicht allein nicht aus. Prüfgegenstand, Verfahren, Umfang und Befunde müssen erkennbar sein. Auch ausgeschlossene Daten und ihre Auswirkungen auf die Bewertung gehören zur Dokumentation.
Der Datenqualifizierungsbericht bewertet die Eignung
Der Bericht führt die Ergebnisse zusammen und bewertet, ob die festgelegten Kriterien erfüllt sind. Er benennt verbleibende Lücken und hält abschließend fest, ob und mit welchen Einschränkungen die Datenbasis für den vorgesehenen KI-Einsatz geeignet ist.
Das Ergebnis sollte sich auf eine konkrete Datenversion und Verwendung beziehen. Eine pauschale Aussage wie „Datenqualität ausreichend“ lässt offen, welche Produkte, Bedingungen oder Aufgaben tatsächlich abgedeckt sind.
Die Datenqualifizierung trägt zum dokumentierten Eignungsnachweis des Gesamtsystems bei. Modellleistung, Schnittstellen, Fehlerbehandlung und die Eignung im vorgesehenen Prozess benötigen weitere, aufeinander abgestimmte Bewertungen.
Datenbasis vortrainierter Modelle und Wissensassistenten
Auch bei einem vortrainierten Modell bleibt zu klären, welche Eingaben und Prüfdaten für den konkreten Einsatz geeignet sind. Hinzu kommen die Bewertung verfügbarer Lieferantennachweise und der Umgang mit fehlenden Informationen.
Ein Wissensassistent benötigt ebenfalls eine geeignete Datenbasis. Bei Retrieval-Augmented Generation, kurz RAG, werden passende Inhalte aus einer Wissensbasis abgerufen und dem Sprachmodell zur Antwortbildung bereitgestellt.
Für einen Assistenten zu Arbeitsanweisungen sind beispielsweise Quellenfreigabe, Gültigkeitsstand, Standortbezug sowie die vollständige und korrekte Übernahme der für den Anwendungsfall benötigten Inhalte in die Wissensbasis relevant. Eine gepflegte Wissensbasis allein belegt allerdings noch nicht, dass die Anwendung passende Inhalte findet und fachlich zutreffende Antworten erzeugt.
Auch bei generativer KI und RAG-Wissensassistenten hängt die regulatorische Einordnung vom konkreten Einsatz ab. Welche Regelwerke greifen und wann eine Validierung erforderlich ist, erläutern wir im Beitrag KI in GMP- und MedTech-Unternehmen: Welche Regelwerke greifen – und wann ist eine Validierung erforderlich?.
Datenqualität über den Lebenszyklus sichern
Ein Eignungsnachweis bezieht sich auf einen definierten Stand und dessen Einsatzbedingungen. Neue Produkte, geänderte Messmethoden oder zusätzliche Standorte können diese Grundlage verändern. Verändert sich im Betrieb die Verteilung der Eingabedaten, etwa bei Bildhelligkeit oder Verpackungsvarianten, spricht man von Daten-Drift. Dadurch kann sich die Leistung auch bei unverändertem Modell verändern. (Annex-22-Entwurf, Abschnitte 10.3–10.4)
Für den Betrieb ist festzulegen, welche Änderungen oder Datenprobleme eine erneute Bewertung auslösen und wer diese verantwortet. Die Zuständigkeiten aus der Data Governance sollten mit Änderungsmanagement und periodischer Bewertung verknüpft werden. Datenqualitätskennzahlen und Modellleistung sind dabei gemeinsam zu betrachten.
Regulatorische Vorgaben und methodische Gestaltung unterscheiden
EU-GMP Annex 11 beschreibt risikobasierte Anforderungen an Validierung, Dokumentation und Datenverarbeitung. Der Konsultationsentwurf zu Annex 22 behandelt ergänzend KI-spezifische Themen wie repräsentative Testdaten und deren Unabhängigkeit. Nach dem am 15. Oktober 2026 geprüften amtlichen Veröffentlichungsstand ist Annex 22 weiterhin als Entwurf einzuordnen. (EudraLex Volume 4, Konsultation zu Annex 22)
Ob Daten für eine KI-Anwendung geeignet sind, bestimmt sich nach ihrem vorgesehenen Verwendungszweck. QbD unterstützt die frühzeitige Planung der Datenqualität; Data Governance regelt Verantwortung und Entscheidungen über den Lebenszyklus. Die hier vorgeschlagene Datenqualifizierung strukturiert die Prüfung und Dokumentation der Dateneignung. Ihr Umfang richtet sich nach Verwendungszweck, Risiko und vorhandenen Nachweisen.
Sie möchten die Datenbasis eines geplanten KI-Einsatzes bewerten? Sprechen Sie mit QMVP über Ihren Anwendungsfall, die vorhandenen Daten und die erforderlichen Nachweise.
Quellen und Fundstellen
- ICH Q8(R2), Pharmaceutical Development, August 2009: Teil II, Abschnitt 4, Glossar „Quality by Design“, gedruckte Seite 16 / PDF-Seite 20. Die Übertragung auf KI-Daten ist ein methodischer Vorschlag. Originaldokument
- PIC/S PI 041-1, Good Practices for Data Management and Integrity in Regulated GMP/GDP Environments, 1. Juli 2021: Abschnitte 5.1–5.2 zu Data Governance; 7.4–7.5 zu ALCOA+. Inspektionsleitlinie. Originaldokument
- EMA/INS/GCP/112288/2023, Guideline on computerised systems and electronic data in clinical trials, 9. März 2023, finale Fassung: Abschnitt 4.5, Seiten 12–13, zu ALCOA++ einschließlich Rückverfolgbarkeit. Geltungsbereich: klinische Prüfungen (GCP). Originaldokument
- EU-GMP Kapitel 4, Documentation, Konsultationsentwurf 2025: Nr. 4.63, Tabelle 1, und Glossar „ALCOA++“ zu Datenintegrität einschließlich Rückverfolgbarkeit. Entwurf; keine geltende Endfassung. Entwurfsdokument
- EU-GMP Annex 11, Computerised Systems, Revision Januar 2011, gültig seit 30. Juni 2011: Nr. 1–7 zu Risikomanagement, Verantwortlichkeiten, Lieferanten, Validierung und Datenverarbeitung; Nr. 10–12 zu Änderungsmanagement, periodischer Bewertung und Zugriffsschutz; Glossar „System owner“ zur Datensicherheit. Originaldokument
- EMA-Reflection-Paper: Reflection paper on the use of Artificial Intelligence (AI) in the medicinal product lifecycle, EMA/CHMP/CVMP/83833/2023, finale Fassung September 2024: Abschnitte 2.5.1–2.5.2 und 2.6 zu Datenaufbereitung, Datentrennung und Governance. Verabschiedetes Reflection Paper. Originaldokument
- EU-GMP Annex 22, Konsultationsentwurf 2025: Abschnitte 3.2 und 5.1–5.5 zu Untergruppen und Testdaten, 6.1 und 6.4 zur Testdatenunabhängigkeit sowie 10.3–10.4 zur Überwachung im Betrieb. Keine geltende Endfassung. Entwurfsdokument